깃허브(GitHub)가 미국 시간 10월 28일 개발자 행사 '깃허브 유니버스 2026'에서 깃허브 코파일럿 퓨전(GitHub Copilot Fusion)을 정식 출시했습니다. 작업마다 어떤 AI 모델을 쓸지, 여러 모델을 어떻게 조합할지를 코파일럿이 알아서 정해 주는 기능입니다.
지금까지 코파일럿 사용자는 클로드, GPT, 제미나이 등 수십 개 모델 중 하나를 직접 고르거나, 모델 하나를 골라 주는 '자동(Auto)' 선택에 맡겨야 했습니다. 깃허브 코파일럿 퓨전을 선택하면 사용자는 모델 대신 '노력 수준(Effort level)'만 정하고, 나머지는 코파일럿이 결정합니다. 표준 단계는 무료 플랜에서도 쓸 수 있습니다.
이번 포스팅에서는 깃허브 코파일럿 퓨전이 무엇인지, 노력 수준 3단계와 실행 방식의 차이, 사용법, 요금제별 이용 범위, 그리고 쓰기 전에 알아 둘 주의 사항까지 정리하겠습니다.
깃허브 코파일럿 퓨전이란?
공식 문서는 코파일럿 퓨전을 '지능형 런타임 모델 라우터이자 오케스트레이터'라고 설명합니다. 작업에 맞는 모델과 실행 방식을 고른 뒤 하나의 응답으로 돌려준다는 뜻입니다. 예를 들어 초안은 한 모델이 쓰고, 검토는 다른 모델이 맡을 수 있습니다.
※ 라우터는 요청을 알맞은 모델로 보내 주는 장치이고, 오케스트레이션은 여러 모델이 한 작업을 나눠 맡도록 순서와 역할을 조율하는 일을 말합니다.
퓨전은 두 가지 기존 기능을 합친 것입니다. 하나는 9월 4일 연구 프리뷰로 공개된 '프로젝트 히드라퓨전(Project HydraFusion)'의 여러 모델 협업 기술이고, 다른 하나는 코파일럿의 기존 '자동 모델 선택(Auto)' 기능입니다. 연구 프리뷰에서 Auto, HydraFusion, HydraFusion Max를 쓰던 사용자는 그에 맞는 퓨전 노력 수준으로 자동으로 옮겨집니다.
모델을 고를 때는 작업 내용뿐 아니라 실시간 시스템 상태와 가용성도 따집니다. 또 대화의 메인 흐름은 가능한 한 같은 모델에 유지해 캐시된 토큰의 이점을 살리고, 검토를 돕는 모델에는 필요한 맥락만 넘깁니다. 비용을 아끼면서 품질을 맞추려는 설계입니다.
깃허브가 공개한 AT&T 엔지니어의 사용 후기도 같은 문제를 짚습니다. 개발자가 어려운 작업에 비싼 모델을 골랐다가 일상 작업으로 돌아올 때 다시 바꾸는 것을 잊는 일이 잦았는데, 퓨전 Standard가 이 부분을 자동으로 처리해 토큰 효율이 좋아졌다는 내용입니다. 비슷한 방식의 자동 모델 선택은 노션 AI 에이전트의 Auto 모델 라우터에서도 볼 수 있습니다.
깃허브 코파일럿 퓨전 노력 수준 3단계
깃허브 코파일럿 퓨전에서 사용자가 고르는 것은 노력 수준입니다. 공식 문서에 정리된 단계별 차이는 아래와 같습니다.
| 노력 수준 | 우선순위 | 알맞은 작업 | 이용 가능 요금제 |
| Fusion Standard | 비용·품질·응답 속도의 균형 | 일상적인 코딩. 작업마다 모델 하나를 고름 | 모든 요금제(Free 포함) |
| Fusion High | 여러 모델 협업, 토큰은 적당히 절약 | 복잡한 버그 수정, 여러 파일에 걸친 변경처럼 범위가 분명한 큰 작업 | Pro+, Max, Business, Enterprise |
| Fusion Max | 최상위 성능, 토큰 효율도 고려 | 가장 깊은 추론과 철저한 분석이 필요한 작업 | Pro+, Max, Business, Enterprise |
※2026. 11. 2(월) 기준
이 밖에 'Fusion Fast'라는 단계도 있지만, 사용자가 고를 수 없고 빠른 모델이 필요한 VS Code 인라인 채팅에서만 쓰입니다.
High와 Max는 한 작업에 모델을 여러 개 쓸 수 있어 Standard보다 AI 크레딧을 더 쓸 수 있습니다. 공식 문서도 High는 추가 모델 호출에 드는 시간과 크레딧을 들일 만한 작업에 쓰라고 안내합니다. 평소에는 Standard로 두고, 막히는 작업에서만 High나 Max로 올리는 방식이 무난해 보입니다.
실행 방식 3가지 – 싱글·캐스케이드·크리틱
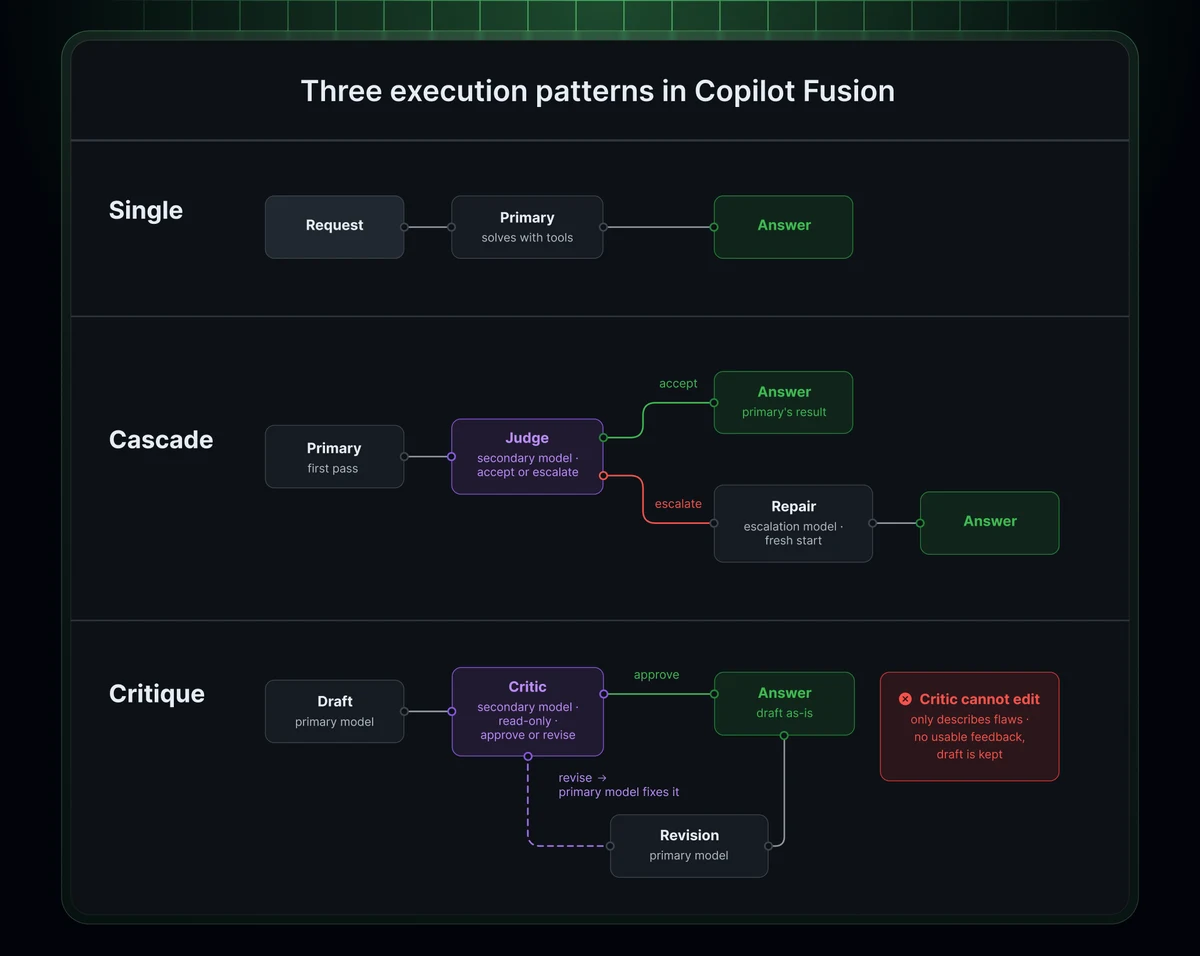
깃허브 코파일럿 퓨전은 노력 수준과 작업 내용에 따라 세 가지 실행 방식 중 하나를 고릅니다. 프롬프트마다 다시 고르기 때문에, 같은 대화 안에서도 첫 요청은 싱글, 다음 요청은 크리틱으로 처리될 수 있습니다.
1. 싱글(Single)
모델 하나가 작업을 바로 끝냅니다. 모델 하나에 요청한 것과 똑같이 동작합니다.
2. 캐스케이드(Cascade)
효율적인 모델이 먼저 초안을 쓰고, 심사 단계가 초안을 검사해 그대로 받아들일지 더 강한 모델로 넘길지 정합니다.
3. 크리틱(Critique)
한 모델이 초안을 쓰면 여러 모델이 동시에 따로 검토하고, 그 의견을 모아 처음 모델이 답을 고칩니다. 깃허브 관계자는 이를 '자기 숙제를 스스로 채점하지 않게 하는 것'에 비유했습니다(iTWire 보도).
실행 방식을 고르는 단계 자체는 지연이 거의 없지만, 캐스케이드와 크리틱은 검토용 모델 호출이 더해져 시간이 더 걸립니다. 대신 간단한 작업에는 필요 없는 검토를 붙이지 않아, 기다리거나 크레딧을 더 쓰지 않는다는 것이 깃허브의 설명입니다.
깃허브 코파일럿 퓨전 성능 – 클로드 코드와 비교
깃허브는 변경 로그에서 퓨전 Max가 아티피셜 애널리시스(Artificial Analysis)의 코딩 에이전트 인덱스에서 60점을 받아, 클로드 오퍼스 5.5 맥스를 쓴 클로드 코드와 2점 이내 차이였다고 밝혔습니다. 같은 결과를 내는 데 작업당 평균 API 비용은 약 절반, 토큰은 약 절반, 작업 시간은 약 40% 적게 들었다는 설명입니다.
아티피셜 애널리시스의 코딩 에이전트 인덱스 페이지에서 클로드 코드(클로드 오퍼스 5.5, Max)는 62점, 작업당 평균 API 비용은 11.42달러로 나옵니다. 클로드 코드가 어떤 모델인지는 클로드 오퍼스 5.5의 성능과 가격 정리를 참고해 보세요.
다만 비용·시간 수치는 깃허브가 밝힌 것이고, 수치도 발표마다 조금씩 다릅니다. 깃허브 커뮤니티 공지에는 딥SWE(DeepSWE) 기준 '최대 8.7점 높고 비용은 최대 77% 낮다'는 문구가 있고, 사티아 나델라 마이크로소프트 CEO는 링크드인에 '최대 77% 저렴하다'고 적었습니다(The Next Web 보도). 실제 비용은 작업과 저장소에 따라 달라질 수 있습니다.
깃허브 코파일럿 퓨전 사용법
깃허브 코파일럿 퓨전은 VS Code, 깃허브 코파일럿 앱, 코파일럿 CLI, 젯브레인(JetBrains) IDE에서 쓸 수 있습니다. 다른 클라이언트도 곧 지원할 예정이라고 하지만 시점은 공개되지 않았습니다.
1. 클라이언트 업데이트
공식 안내는 먼저 쓰는 도구를 최신 버전으로 올리라고 합니다. VS Code, 코파일럿 앱, 코파일럿 CLI, 젯브레인 IDE 등 쓰는 클라이언트를 최신 버전으로 업데이트합니다.
2. 모델 선택기에서 Copilot Fusion 선택
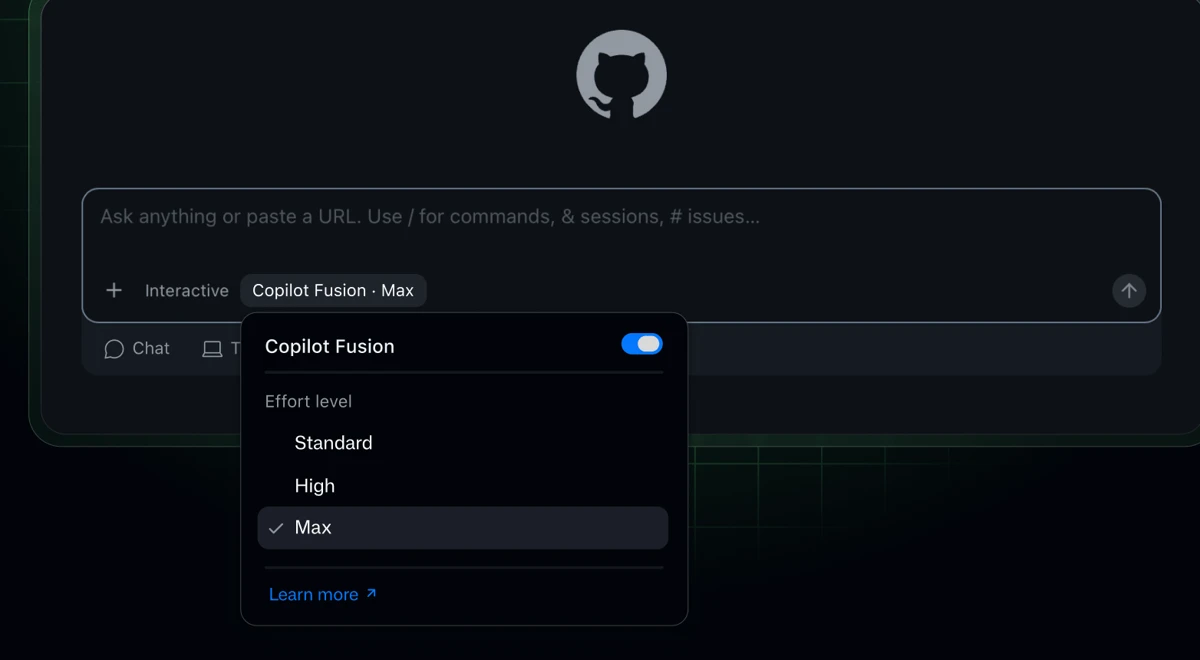
모델 선택기(model picker)를 열고 Copilot Fusion을 고릅니다(코파일럿 CLI는 /model 명령). 특정 모델이 아니라 모델을 골라 주는 시스템을 선택하는 것이므로, 작업 중간에 모델을 바꿀 필요가 없습니다.
3. 노력 수준 고르기
Standard, High, Max 중 하나를 고르고 평소처럼 요청을 입력합니다. 작업이 진행되는 동안 단계별 진행 상황과 그 단계에서 쓰는 모델이 표시됩니다. 중간 초안은 고쳐지거나 버려질 수 있어 최종 응답만 보여 줍니다.
4. 사용된 모델 확인
응답이 끝나면 응답 아래의 노력 수준 이름에 마우스를 올려 이번 작업에 쓰인 모델 목록을 볼 수 있습니다. 퓨전이 고르는 모델 목록은 고정되어 있지 않고, 새 모델이 나오거나 깃허브의 평가 결과에 따라 바뀝니다.
✅ 모델 선택기에 Copilot Fusion이 보이지 않는다면 클라이언트 버전부터 확인하세요. 젯브레인용 변경 로그에 따르면 퓨전은 기존 Auto 옵션을 대체하며 모든 사용자에게 순차 배포 중입니다. 회사 계정이라면 관리자가 퓨전이 쓸 모델을 모두 막아 둔 경우에도 선택기에 나타나지 않습니다.
로컬 모델과 함께 쓰기(선택, 공개 미리 보기)
컴퓨터에 MAI Code 1.1 Flash(윈도우)나 Qwen3.8 Flash Next(코파일럿 CLI, 윈도우·맥·리눅스) 모델을 설치해 두면, Fusion Standard가 상황에 따라 내 컴퓨터의 모델을 쓰기도 합니다. 코파일럿 앱은 설정의 실험 기능 항목(변경 로그 표기 Settings > Experiments, 문서 표기 'Experimental')에서 Local model auto routing을 켜고, CLI는 --experimental 옵션이나 /experimental on 명령으로 실험 기능을 켭니다.
다만 깃허브는 로컬 모델을 써도 세션이 오프라인이 되는 것은 아니라고 밝혔습니다. 어떤 모델을 쓸지는 여전히 클라우드에서 정하고, 로컬 모델은 코파일럿이 제공하는 클라우드 모델과 안전 장치가 다를 수 있습니다.
깃허브 코파일럿 퓨전 요금과 무료 범위
깃허브 코파일럿 퓨전 자체에는 별도 요금이 없습니다. 퓨전이 실제로 쓴 모델마다 그 모델의 표준 요율대로 AI 크레딧이 빠집니다. AI 크레딧은 1크레딧이 0.01달러이고, 모델마다 100만 토큰당 가격이 다릅니다.

요금제별로 매달 받는 AI 크레딧과 퓨전 노력 수준을 정리하면 다음과 같습니다. 개인 요금제 가격은 위 이미지와 같고, 기업용인 Business는 사용자당 월 19달러, Enterprise는 사용자당 월 39달러입니다.
| 요금제 | 월 포함 AI 크레딧 | 퓨전 노력 수준 |
| Free | 제한된 채팅·에이전트 사용(수치 미공개) | Standard |
| Student(인증 학생 무료) | 포함(수치 미공개) | Standard |
| Pro | 1,500(기본 1,000 + 추가분 500) | Standard |
| Pro+ | 7,000(기본 3,900 + 추가분 3,100) | Standard, High, Max |
| Max | 20,000(기본 10,000 + 추가분 10,000) | Standard, High, Max |
| Business | 사용자당 1,900 | Standard, High, Max |
| Enterprise | 사용자당 3,900(Business보다 2,000 더) | Standard, High, Max |
※2026. 11. 2(월) 기준
2026년 11월 30일까지는 유료 요금제 사용자가 퓨전을 쓸 때 모델 비용이 30% 할인됩니다. 포함된 크레딧은 다음 달로 이월되지 않고 매월 1일 0시(UTC)에 다시 채워집니다. 개인 유료 요금제(Pro·Pro+·Max)는 크레딧을 다 쓰면 상위 요금제로 올리거나(차액만 결제), 달러로 추가 사용 예산을 정해 계속 쓸 수 있습니다. Free는 추가 크레딧을 살 수 없고, Business·Enterprise 사용자는 관리자에게 예산을 요청할 수 있습니다.
요금은 모두 달러 기준이며, 요금제 페이지에 원화 가격은 표시되지 않습니다. 코드 자동 완성과 다음 편집 제안은 AI 크레딧을 쓰지 않고 유료 요금제에서 무제한입니다(Free는 월 2,000회).
깃허브 코파일럿 퓨전 쓰기 전 주의할 점
공식 문서가 밝힌 제한 사항과 운영상 알아 둘 점을 정리했습니다.
- 버려진 초안의 파일 변경은 자동으로 되돌려지지 않습니다. 커밋하기 전에 작업 공간의 변경 내용을 직접 확인해야 합니다.
- 퓨전에는 자체 컨텍스트 창이 없습니다. 각 단계는 그 단계를 실행하는 모델의 한도를 따르고, 화면에 표시되는 값은 참여 모델 중 가장 작은 한도 기준입니다.
- 퓨전은 서브에이전트와 따로 동작하며 서브에이전트를 실행하지 않습니다.
- 실행 방식과 모델 목록은 앞으로 바뀔 수 있습니다.
- 회사 계정은 관리자 정책에서 허용한 모델만 씁니다. 엔터프라이즈 관리자는 특정 모델을 퓨전에서만 끄거나, 엔터프라이즈 관리 설정(Enterprise managed settings)으로 퓨전을 기본 모델로 지정할 수 있습니다.
깃허브 커뮤니티 공지 댓글에는 Business 요금제 관리자가 출시 직후 VS Code 모델 선택기와 설정 어디에서도 퓨전이 보이지 않는다고 남긴 글이 있습니다. 젯브레인용 변경 로그에 순차 배포 중이라고 나와 있고, 공식 문서도 퓨전이 쓸 수 있는 모델이 하나도 없으면 모델 선택기에 나타나지 않는다고 안내하니, 보이지 않을 때는 관리자 정책도 함께 확인해 보세요.
에이전트에게 긴 작업을 맡기는 흐름은 다른 도구에서도 비슷합니다. 클로드 코드의 /loop·/goal 반복 작업 기능처럼, 결과물은 항상 사람이 검토한 뒤 반영하는 습관이 필요합니다.
지금까지 깃허브 코파일럿 퓨전의 노력 수준과 실행 방식, 사용법, 요금제별 이용 범위에 대해 함께 살펴보았습니다.
모델이 쏟아져 나오면서 '어떤 모델을 쓸지' 고르는 일 자체가 개발자의 부담이 되었는데, 깃허브 코파일럿 퓨전은 이 선택을 시스템에 맡기는 쪽으로 방향을 잡았습니다. 무료 플랜에서도 Standard를 써 볼 수 있고, 유료 요금제라면 퓨전 모델 비용이 30% 할인되는 11월 30일까지 평소 작업으로 비용과 결과를 직접 비교해 보는 것도 좋겠습니다.
앞으로는 모델 하나의 성능보다 여러 모델을 얼마나 잘 조합하느냐가 코딩 도구의 경쟁 포인트가 될 것으로 보입니다. 관심 있는 독자분께서는 아래 포스팅도 참조 부탁드립니다.