중국 AI 기업 딥시크(DeepSeek)가 2026년 10월 17일 딥시크 V4.1 플래시의 업데이트 버전 'DeepSeek-V4.1-Flash-1017'을 공개하고 웹, 앱, API에 바로 적용했습니다.
딥시크는 이번 버전이 이전보다 벤치마크 성능은 높아지고 작업은 더 빨리 끝내며 답변은 더 짧아져, 성능과 비용을 함께 개선했다고 설명합니다. 같은 날 자체 검색 엔진을 쓰는 검색·페치(Search & Fetch) API도 모든 개발자에게 열었습니다.
이번 포스팅에서는 이번 업데이트에서 달라진 점, 벤치마크 성능, 웹·앱·API에서 쓰는 방법, API 가격, 그리고 한국에서 쓸 때 알아 둘 점까지 정리하겠습니다.
딥시크 V4.1 플래시 1017이란?
딥시크 V4.1 플래시는 지난 9월 10일 나온 딥시크의 최신 모델입니다. 공식 발표에 따르면 새 아키텍처 계열에서 가장 작은 모델로, 5,520억 개 매개변수를 가진 MoE(전문가 혼합) 구조이면서 입력에는 80억 개, 출력에는 160억 개 매개변수만 활성화해 비용을 낮췄고, 이미지도 바로 이해합니다.
이번 1017 버전은 이 모델의 작은 업데이트로, 모델 이름 뒤 숫자 '1017'은 공개일(10월 17일)과 같은 숫자입니다. 딥시크는 이번 업데이트를 '원하는 것을 말하면 만들어지는 프로그래밍(Wish-Driven Programming)'이라고 소개합니다.
딥시크 V4.1 플래시 1017 달라진 점 4가지
1. 성능은 높이고 작업 시간과 답변 길이는 줄임
공식 모델 카드에 따르면 추론, 코딩, 에이전트 작업, 시각 벤치마크 전반에서 이전 V4.1 플래시보다 점수가 올랐고, 작업 실행 시간과 출력 길이는 더 짧아졌습니다. 답변이 짧아지면 같은 일을 하는 데 드는 토큰이 줄어 API 비용도 줄어듭니다.
2. 처음부터 끝까지 프로젝트 만들기
스스로 결과를 평가해 배우는 강화학습으로 게임 제작부터 3D 모델링까지 프로젝트 전체를 개발하는 능력을 높였습니다. 공식 발표는 자금성 3D 모델링, 웹 레이싱 게임, 고도(Godot) 엔진으로 만든 포털 2 재현 같은 예시를 공개했습니다.
3. 에이전트 도구 최적화
딥시크가 공개 미리보기로 내놓은 오픈소스 에이전트 도구 딥시크 하네스(DeepSeek Harness)와 텐센트 코드버디(CodeBuddy), 워크버디(WorkBuddy) 등에 맞춰 최적화했습니다. 딥시크 하네스는 v0.2.1-rc.1 이상으로 업데이트해야 새 모델을 가장 잘 쓸 수 있습니다.
4. 검색·페치 API 공개와 오픈 웨이트
하루 수억 건의 요청을 처리하는 딥시크 자체 검색 엔진을 쓰는 검색(Search)·페치(Fetch) API를 모든 개발자에게 열었습니다. 모델 가중치도 허깅페이스와 모델스코프에 MIT 라이선스로 공개해, 누구나 내려받아 직접 서버에서 돌릴 수 있습니다.
V4.1 플래시 1017 벤치마크 성능
딥시크가 공개한 표에서 1017 버전은 코딩 에이전트 벤치마크 DeepSWE v1.1에서 77.0점으로, 이전 V4.1 플래시(74.2점)와 비교 대상인 GPT-5.6 Sol, Claude Opus 5보다 높았습니다. Automation-Bench, Agents' Last Exam, Apex Bench에서도 비교 모델 중 가장 높은 점수를 받았습니다.
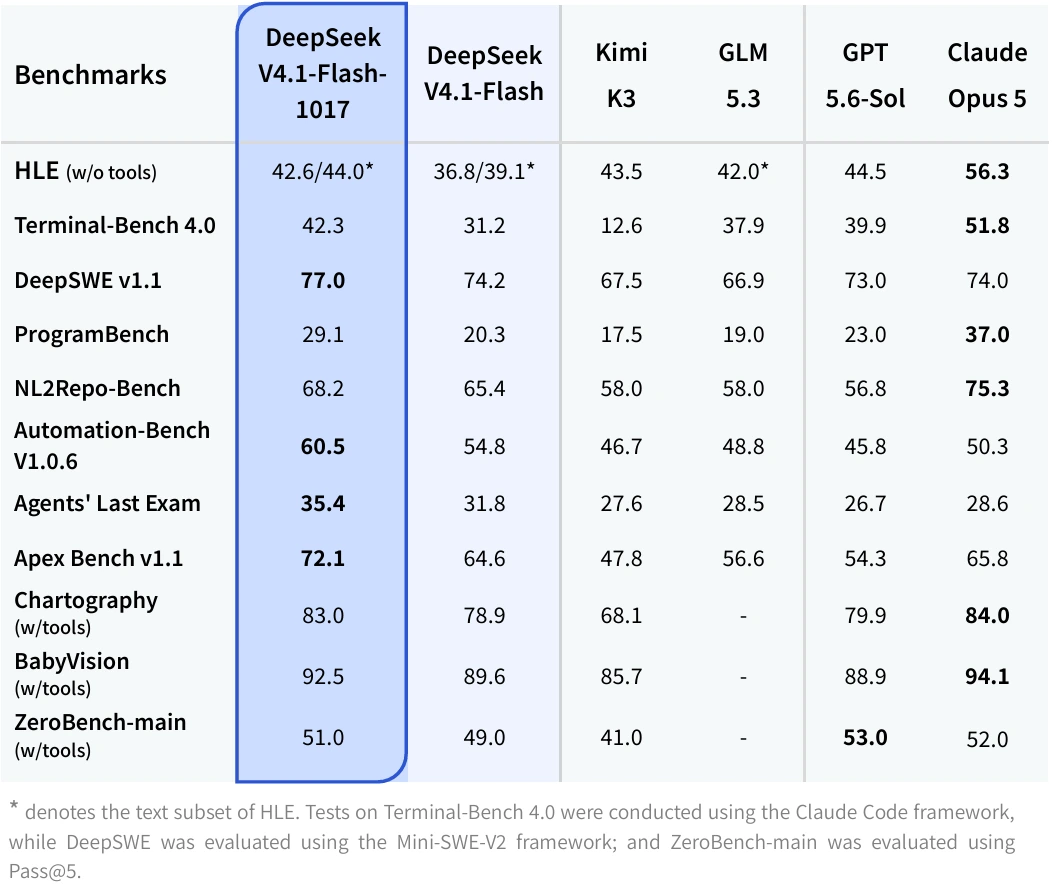
반대로 HLE, Terminal-Bench 4.0, ProgramBench 같은 항목에서는 Claude Opus 5가 더 높았습니다. 모든 항목에서 앞서는 것은 아니며, 딥시크는 이전 버전보다 성능과 비용이 함께 나아졌다고(파레토 개선) 설명하고 비용 비교는 아래 DeepSWE v1.1 그래프로 공개했습니다.
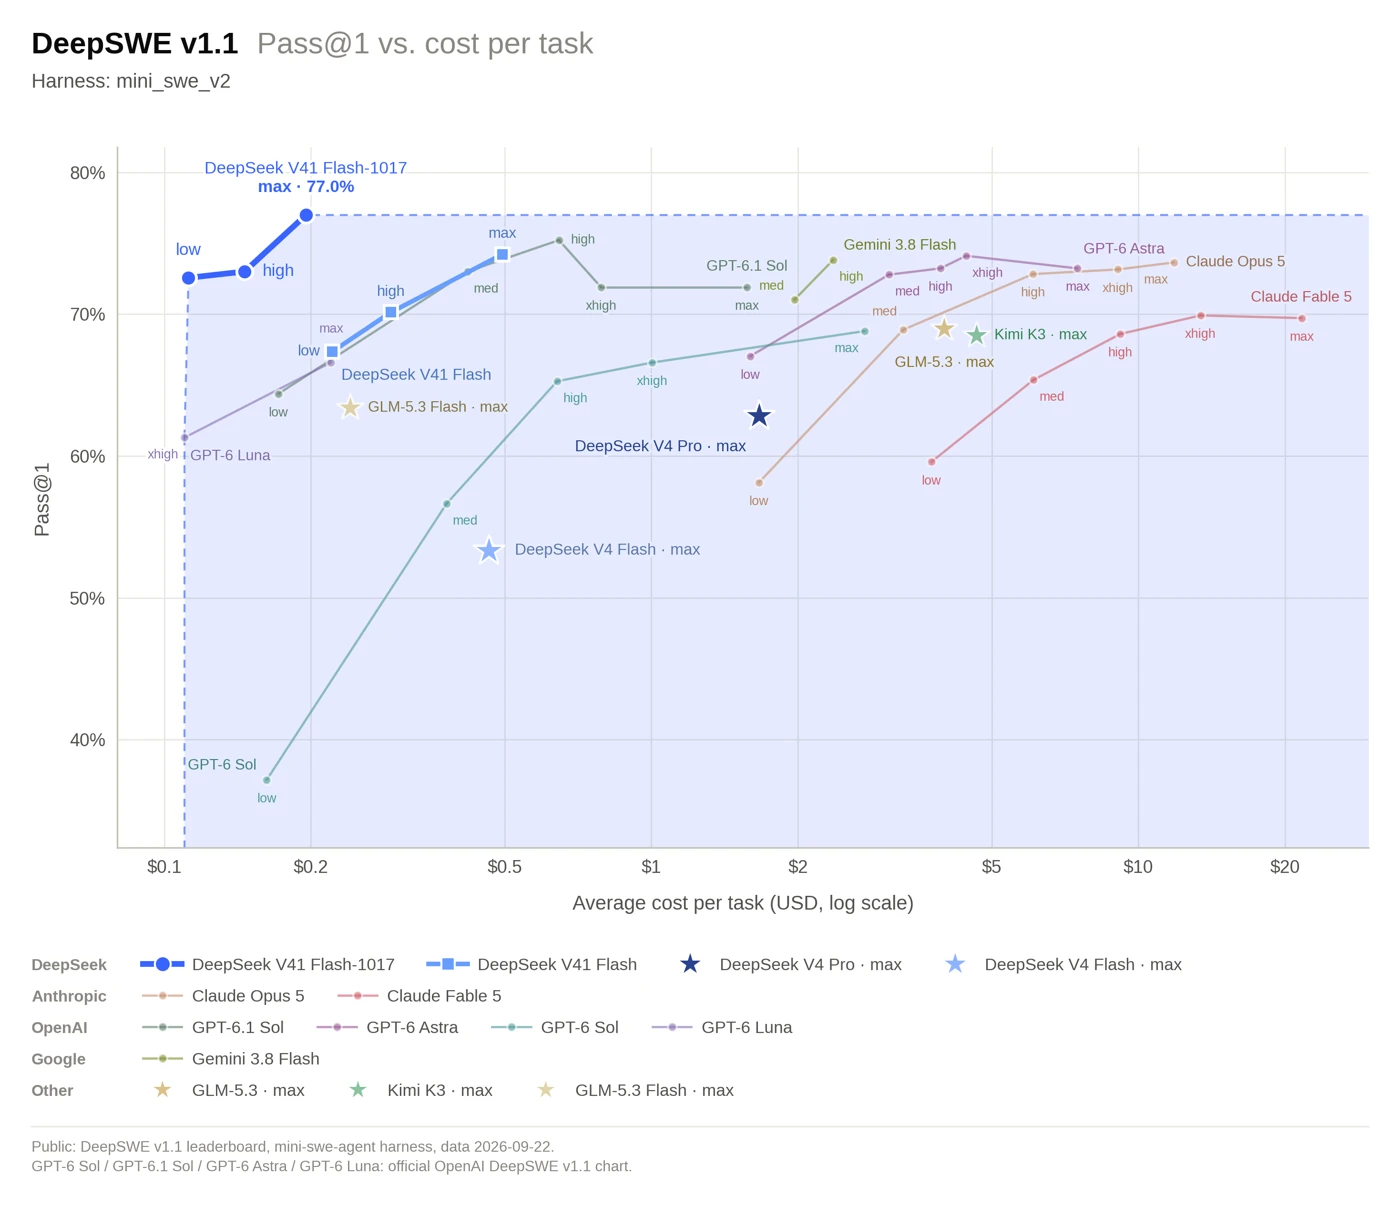
위 그래프는 DeepSWE v1.1 점수와 작업 1건당 평균 비용을 함께 보여 줍니다. 딥시크 V4.1 플래시 1017은 가장 높은 점수(max 설정 77.0%)를 작업당 평균 약 0.2달러 선에서 낸 것으로 표시돼 있어, 1달러 이상 구간에 몰린 클로드 오퍼스 5나 GPT-6 계열 상위 설정 대부분보다 왼쪽(저비용 쪽)에 있습니다. 1017 수치는 딥시크가 직접 측정한 결과이고, 다른 모델 수치는 그래프 아래 적힌 대로 공개 DeepSWE v1.1 리더보드(2026년 9월 22일 데이터)와 오픈AI 공식 차트에서 가져왔습니다.
딥시크 V4.1 사용법 – 웹·앱·API
- 웹: 딥시크 홈페이지(deepseek.com)에서 Chat with DeepSeek을 누르거나 chat.deepseek.com에 접속해 로그인하면 됩니다. 입력창에는 DeepThink(생각 모드)와 Search(웹 검색) 버튼이 있으며, 각 버튼의 동작은 공식 도움말에 따로 설명돼 있지 않습니다.
- 앱: 앱스토어·구글 플레이에서 DeepSeek 앱을 설치해 쓰면 됩니다. 1017 버전은 웹·앱에도 적용됐습니다.
- API: 개발자는 API 플랫폼에서 키를 발급받아 모델 이름을
deepseek-flash로 지정하면 1017 버전을 씁니다. 오픈AI 형식과 앤트로픽 형식 API를 모두 지원해 클로드 코드(Claude Code), 코덱스(Codex) 같은 도구에 연결할 수도 있습니다. - 직접 설치: 허깅페이스의 가중치를 내려받아 vLLM, SGLang 같은 도구로 직접 서버에서 돌릴 수 있습니다. 다만 공식 발표 기준 5,520억 매개변수 MoE 모델이라 규모가 크며, 필요한 하드웨어 사양은 모델 카드에 따로 안내돼 있지 않습니다.
딥시크 공식 다운로드 페이지는 앱을 최고 수준의 AI 모델과 무료로 대화할 수 있는 공식 AI 비서로 소개하며, 공식 사이트에 웹·앱용 구독 요금제는 없고 가격표는 API용만 공개돼 있습니다. 웹·앱의 사용량 한도는 공식적으로 공개되지 않았습니다.
딥시크 V4.1 API 가격
딥시크 API는 '피크' 시간과 나머지 '오프피크' 시간의 가격이 다르고, 오프피크는 피크의 절반입니다. 피크 시간은 평일 UTC 01:00~04:00, 06:00~10:00(한국 시간 오전 10시~오후 1시, 오후 3시~7시)이며 주말과 중국 공휴일은 종일 오프피크입니다.
| 구분(100만 토큰당) | 오프피크 | 피크 |
| 입력(캐시 적중) | 0.003달러 | 0.006달러 |
| 입력(캐시 미적중) | 0.15달러 | 0.3달러 |
| 출력 | 0.6달러 | 1.2달러 |
※2026. 10. 18(일) 기준, 딥시크 공식 요금 문서의 deepseek-flash(V4.1-Flash-1017) 가격
컨텍스트는 100만 토큰, 최대 출력은 38만 4천 토큰입니다. 검색·페치 API는 성공한 요청 1,000회당 각각 0.75달러이며, 딥시크 하네스·클로드 코드·코덱스에서 서버 쪽 도구로 쓰는 검색·페치는 지금은 무료이고 2026년 11월 1일 오전 1시(한국 시간)부터 과금됩니다. 다른 회사 모델의 API 가격이 궁금하다면 클로드 하이쿠 5.5, 제미나이 4 아르곤 글도 함께 참고하세요.
딥시크 V4.1 한국에서 쓸 때 주의할 점
- 개인정보 이슈가 있었습니다: 딥시크는 2025년 2월 15일 개인정보보호위원회의 권고를 받아들여 한국 앱마켓에서 신규 다운로드를 잠정 중단했다가, 시정 권고를 일부 수용하고 한국어 개인정보 처리방침을 공개한 뒤 2025년 4월 28일 다운로드를 재개했습니다. 당시 이용자 개인정보가 동의 없이 중국·미국 회사로 넘어갔고, 프롬프트에 입력한 내용까지 바이트댄스 계열사 볼케이노로 전송된 점이 문제가 됐습니다.
- 민감한 정보는 입력하지 마세요: 회사 기밀, 개인정보, 계정 정보는 웹·앱·API 어디에도 넣지 않는 것이 안전합니다. 회사에서 쓴다면 사내 규정을 먼저 확인하세요.
- API 가격은 달러·충전식입니다: 충전한 잔액에서 사용량만큼 빠지며, 가격은 바뀔 수 있으니 공식 요금 문서를 수시로 확인하세요.
- 벤치마크는 자체 발표입니다: 성능 수치는 딥시크가 공개한 결과라, 실제 업무에 쓰기 전에 직접 시험해 보는 것이 좋습니다.
지금까지 딥시크 V4.1 플래시 1017 업데이트에서 달라진 점과 성능, 웹·앱·API 사용법, API 가격, 한국에서 쓸 때 주의할 점에 대해 함께 살펴보았습니다.
이번 업데이트는 코딩 에이전트 성능을 끌어올리면서도 답변을 짧게 만들어 비용을 줄였다는 점이 핵심입니다. 오픈 웨이트로 공개돼 직접 설치할 수 있고, API 가격도 낮아 AI 코딩 도구를 싸게 쓰고 싶은 개발자에게 눈여겨볼 만한 선택지입니다.
다만 개인정보 처리와 관련된 우려가 있었던 만큼 민감한 내용은 피하고, 용도에 맞게 다른 모델과 비교해 고르는 것이 좋습니다. 다른 AI 회사의 최신 모델이 궁금한 독자분께서는 아래 포스팅을 참조 부탁드립니다.